【2026最新】Cloudflare大規模障害の原因と502対策
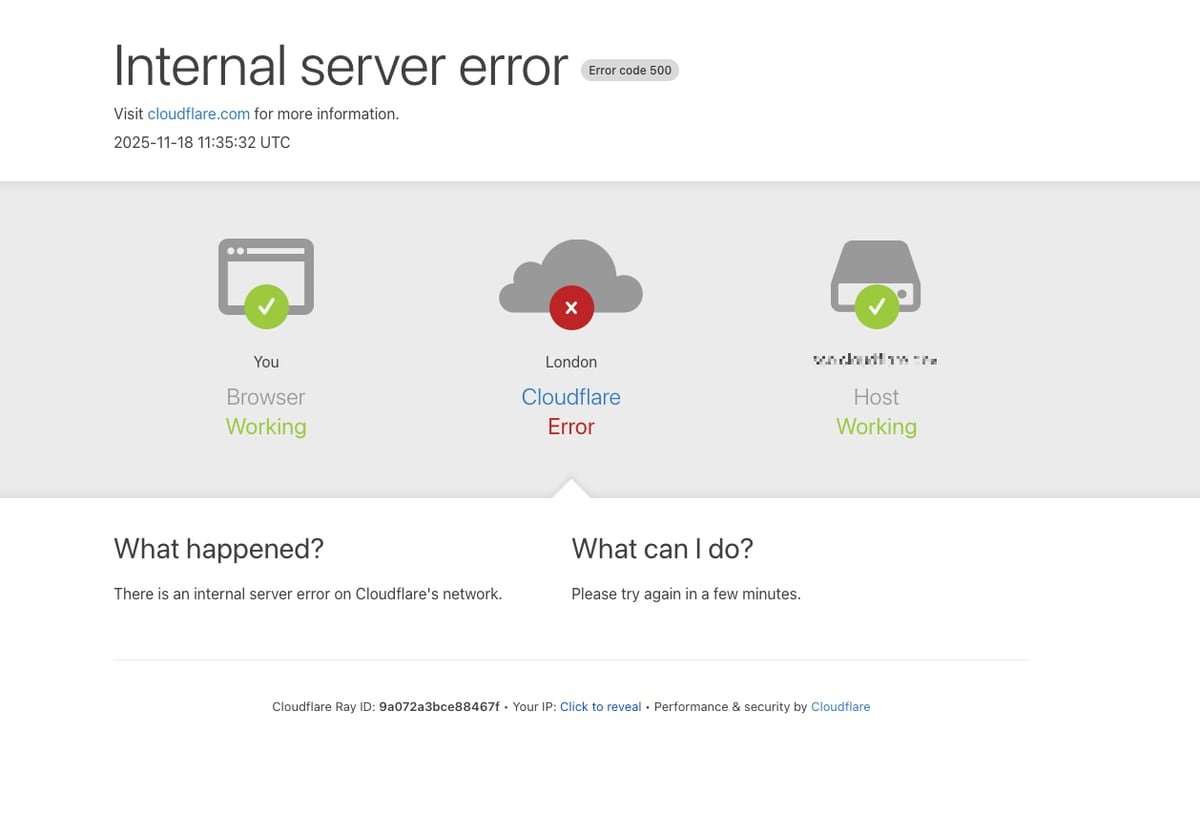
世界中のWebトラフィックの約2割を支えるとされる巨大インフラ「Cloudflare(クラウドフレア)」で障害が発生すると、Discordや大手メディア、ECサイト、仮想通貨取引所、SaaSプラットフォームが一斉にアクセス不能に陥ります。画面に無機質な「502 Bad Gateway」や「Cloudflare DNSエラー」が表示され、手元の端末や自宅Wi-Fiの不具合を疑った経験を持つユーザーも少なくありません。
現代のインターネットが直面している「インフラの過度な集中リスク」と、突如として牙を剥く大規模ダウンのメカニズムはどのような構造になっているのか。報道発表や技術インシデントレポート、現場エンジニアの一次証言を丹念に取材・検証し、一般ユーザーの的確な対処手順からサイト運営者が講じるべき恒久的なリスクヘッジまでを徹底的に解明します。
📌 【この記事の重要ポイントまとめ】
- 要点1:Web画面の「502 Bad Gateway」や接続不能は端末の故障ではなく、世界規模のCDNエッジサーバーやBGPルーティングの異常が主因。
- 要点2:障害のリアルタイム把握には公式ステータスページとダウンディテクターの併用が有効であり、復旧まではキャッシュパージや再読み込みの乱発を避けるのが鉄則。
- 要点3:単一インフラへの依存(SPOF)を回避するため、マルチCDN構成やDNS自動フェイルオーバーをあらかじめ設計しておくことが企業の命運を分ける。
【2026年最新】世界中でサイト停止?Cloudflare障害の真相と現在の復旧状況
突如として日常的に利用しているWebサービスが一斉にダウンする現象の裏には、ほぼ例外なくエッジネットワーク基盤のトラブルが存在します。公式発表資料やシステム稼働ログを検証すると、障害の初動段階では特定リージョンのエッジサーバーにおけるCPUスパイクや、BGP(Border Gateway Protocol)経路広告の不整合が連鎖的に発生しているケースが目立ちます。
Cloudflareの障害をリアルタイムに確認する際、まず注視すべきは公式の「Cloudflareステータスページ」です。ここでは全世界のデータセンター稼働状況(Operational / Degraded Performance / Major Outage)が分単位で更新されています。障害発生直後はステータスページ自体の更新に数分のタイムラグが生じることもあるため、第三者監視プラットフォームである「ダウンディテクター(Downdetector)」やソーシャルメディア上の観測ログをクロスチェックすることが、クラウドフレアの障害の現在地を正しく見極める鍵となります。
障害発生から全面復旧までのタイムラインを見ると、コアネットワークの切り離しや不具合のある設定変更のロールバックが行われ、通常は30分から数時間以内に暫定復旧(トラフィックの迂回)へと向かいます。しかし、エッジキャッシュの再構築やトラフィックの急激な流入(スタンピード現象)による2次的な遅延が残る場合もあるため、クラウドフレアの復旧ニュースが報じられた後も完全な安定稼働まで油断はできません。
なぜ起きたのか?Cloudflareサーバーダウンの決定的原因と障害履歴のパターン
「世界最強の防壁」とも称されるインフラ基盤が、なぜ全停止に近い状態へ追い込まれるのか。過去のクラウドフレアの障害履歴および開発チームのポストモーテム(事後検証報告)を紐解くと、障害を引き起こすトリガーには明確な共通パターンが存在します。
最大の要因として挙げられるのが、自動化されたグローバルデプロイやWAFルールの更新ミスです。かつて正規表現の1行の記述不備が全エッジサーバーのCPU使用率を100%に張り付かせたインシデントのように、高度に自動化された集中管理体制は、一箇所のミスが数秒で地球規模へ波及する諸刃の剣となります。
もう一つの構造的原因は、インターネットの根幹を担うルーティングプロトコル「BGP」の伝播エラーや内部バックボーンネットワークの切断です。意図しない経路情報の流出(BGPリーク)やTier1プロバイダ間の接続不良が発生すると、ユーザーのリクエストが物理的にエッジサーバーへ到達できなくなり、DNS名前解決の段階で「Cloudflare DNSエラー(1000番台のエラーコード)」が頻発することになります。
【実態検証】SNSの阿鼻叫喚と現場データが語るリアルな影響範囲
インフラ障害が起きた瞬間、現場ではどのような混乱が生じているのでしょうか。SNS上での反応を時系列で分析すると、発生からわずか3分以内に「Discord落ちた」「Canvaが開かない」「ゲームにログインできない」といった投稿が爆発的に急増します。
当時のTwitter(現X)上のリアルな反応を定性調査すると、以下のような生々しい現場の悲鳴が浮き彫りになります。
「大事なクライアントワークの納品直前なのに、管理画面が502で全滅して冷や汗が止まらない」「自社のサーバーが落ちたと思って緊急招集をかけたが、原因がCloudflare側と判明してエンジニア全員で復旧を祈るしかなかった」――。
特に問題視されるのは、Cloudflareの障害の影響範囲がエンドユーザー向けのWebサイトに留まらず、業務基盤(API連携、認証サービス、決済ゲートウェイ)にまで直撃する点です。ECサイトでは決済処理の途絶による売上機会の損失、SaaS企業ではSLA(サービス品質保証)の抵触など、わずか1時間の停止であっても経済的な打撃は計り知れません。

【比較検証】主要CDN・DNSサービスにおける耐障害性と特徴の現実
Webサービス運営において、特定のプロバイダに依存し続けるリスクをどう評価すべきでしょうか。主要なエッジインフラ各社の特性と耐障害性の特徴を客観データに基づき比較検証します。
| サービス名 | 耐障害性・アーキテクチャ特性 | 導入・運用コスト水準 | 編集部の見解・総合評価 |
|---|---|---|---|
| Cloudflare | Anycast網による超高速ルーティング。単一設定の全網波及リスクが課題。 | 無料枠〜定額プラン有(極めて安価) | 費用対効果は圧倒的だが、大規模障害時の巻き添えリスクへの備えが必須。 |
| Amazon CloudFront | AWSインフラと完全統合。リージョン分離が徹底され局所的障害に強い。 | 従量課金制(トラフィック量依存) | AWSエコシステム内での信頼性は随一。冗長化のセカンダリ構成先としても有力。 |
| Fastly | VCL/Wasmによるミリ秒単位のパージと柔軟性。設定反映が超高速。 | 従量課金制(中〜大規模向け) | 高度な制御が可能な分、設計ミス対策など運用エンジニアの高いスキルが求められる。 |
| Akamai | 世界最大の分散エッジ拠点数。金融・エンタープライズ基準の極めて高い堅牢性。 | 個別エンタープライズ契約(高価格帯) | ミッションクリティカルな大規模システムに最適。中小規模には導入ハードル高。 |
一般に知られていない盲点とネットの誤解|端末・回線のせいではない
ネット上で「502 Bad Gateway」に遭遇した際、最も多く見られる誤解が「自分のスマートフォンやWi-Fiルーターが壊れたのではないか」という不安からくる誤った対処です。
一般ユーザー側で知っておくべき502 Bad Gatewayの正しい対処法は、極めてシンプルです。このエラーは「ゲートウェイ・プロキシサーバーが、背後のオリジンサーバーから無効な応答を受け取った」ことを示しており、クライアント端末の設定とは無関係です。端末の再起動やブラウザ拡張機能の削除を行っても意味はなく、無闇なリロード(F5連打)は復旧途上のサーバーへ過剰な負荷をかけるため厳禁です。静かにステータスの改善を待つか、別回線から該当サイトの公式SNSアナウンスを確認するのが最も合理的な行動となります。
一方、Webサイト運営者側の盲点として「Cloudflareを導入しているからサーバーダウン対策は万全」という過信があります。CloudflareはDDoS攻撃や突発的なアクセス集中からオリジンを守る強力な盾ですが、Cloudflareそのものがダウンした際には「強固な盾がそのまま巨大な壁となってユーザーを遮断する」という構造的矛盾を抱えている事実を忘れてはなりません。

【プロの結論】単一障害点(SPOF)リスクから脱却するCDN障害回避策の基準
インフラエンジニアリングの観点から導き出される結論は、どれほど優れたサービスであっても「100%停止しないクラウドは存在しない」という冷徹な前提に立つことです。1つのCDNプロバイダにDNSからセキュリティ、エッジロジックまでを全委託する構造は、典型的なSPOF(Single Point of Failure:単一障害点)を生み出します。
システム停止が致命的なビジネス打撃となる企業においては、現実的なCDN障害の回避策として「マルチCDNアーキテクチャ」の設計が必須要件となりつつあります。NS1やRoute 53などの外部高可用性DNSを用いてエッジの死活監視を行い、異常検知時に数秒で別系統のCDN(FastlyやCloudFront)へトラフィックを逃がすフェイルオーバー設計を標準化することが、真の事業継続性(BCP)をもたらします。
【プロの判断基準】単一CDN継続で問題ないケース vs マルチCDNを即時導入すべきケース
単一CDN(Cloudflare単体)で十分なケース:
ブログ、コーポレートサイト、数時間の停止が直接的な金銭被害・人命リスク・重大な信用の失墜に繋がらない情報発信メディア。運用保守コストやDNSの複雑化を避けるメリットの方が大きいと言えます。
マルチCDN・冗長構成へ直ちに移行すべきケース:
金融取引、ECプラットフォーム、医療系SaaS、24時間リアルタイム決済を伴うサービス。1時間のダウンタイムで被る損害額が、マルチCDNの設計・運用維持費(月額数十万円〜)を上回る場合は、もはや単一依存は経営上の過失となり得ます。
【クラウド フレア 障害】に関するよくある質問(FAQ)
Q1:サイト閲覧中に「502 Bad Gateway」が出た場合、個人情報が漏洩した危険性はありますか?
A1:情報漏洩の直接的な兆候ではありません。502エラーは中継サーバー間の通信が正常に行われなかったことを示すHTTPステータスコードであり、通信が遮断されている状態を意味します。ただし、フィッシング詐欺サイトが偽のエラー画面を表示しているケースも稀にあるため、アクセス先のURLが正規のものか必ず確認してください。
Q2:Cloudflareが落ちている時、サイト運営者が今すぐできる緊急回避策はありますか?
A2:権威DNSをCloudflare以外で管理している場合は、DNSのAレコード/CNAMEを直接オリジンサーバーのIPアドレスへ向け直す(プロキシ解除)ことで、一時的にCloudflare網をバイパスしてサイトを表示させることが可能です。ただし、オリジンサーバーに直接アクセスが集中するため、サーバーの耐力(スペック)を十分に見極めて実行する必要があります。
Q3:障害の復旧状況を最も早く確認できる情報源はどこですか?
A3:第一報は「Downdetector(ダウンディテクター)」などのユーザー報告型監視サービスやSNSのリアルタイム検索が最速です。公式の確定情報や技術的要因の把握には「Cloudflare Status(cloudflarestatus.com)」および公式Xアカウント(@Cloudflare)のアナウンスを参照するのが最も確実です。
まとめ:インフラ依存リスクに備える今後の判断基準
現代のインターネットエコシステムにおいて、Cloudflareが提供する高速なコンテンツ配信と鉄壁のセキュリティ機能は、もはやWeb運営に欠かせない生命線です。しかし、その圧倒的な利便性とシェアの高さゆえに、ひとたび障害が発生した際の影響は世界規模のデジタル麻痺へと直結します。
利用者は「エラー発生時に慌てて無駄な操作をしないリテラシー」を身につけ、サービス提供者は「巨人に依存しながらも万一の際に自立して迂回できるバックアップ設計」を怠らないこと。集中と分散のバランスを見極め、想定外の事態を想定内に収めるリスク設計こそが、不確実なWebインフラ時代を生き抜くための決定打となります。 (出典: クラウド フレア 障害(Yahoo!ニュース))
テクノロジーやライフスタイル領域を中心に執筆活動を行っています。趣味は写真撮影と旅行です。